
Em 29 de setembro de 2026, a OpenAI anunciou a Decisions API, baseada no GPT-6 Luna. Dois dias depois, em 1º de outubro, a Cloudflare apresentou Clef e Clef-flash, modelos de decisão com pesos disponíveis sob licença Apache 2.0. Em 6 de outubro, a OpenAI abriu o beta público da sua API.
A disputa chama atenção porque a conversa sobre agentes de IA está avançando de “qual modelo conversa melhor?” para uma questão mais operacional: qual modelo toma uma decisão delimitada com qualidade, rapidez e custo aceitáveis?
Eu já apresentei o Jev, da TypeSafe AI, no artigo “Jev: O Modelo Que Não Escreve Texto e Promete Cortar o Custo de Automação em Até Mil Vezes”, publicado em 23 de setembro. Agora, Clef, Clef-flash e OpenAI Decisions ampliam as opções para empresas que querem automatizar escolhas específicas.
O que é um decision model?
Um modelo de decisão recebe informações e responde a uma pergunta com alternativas ou critérios definidos previamente. Pode classificar um chamado, indicar sua urgência ou avaliar se uma mensagem deve ser encaminhada para uma pessoa.
Em vez de produzir uma resposta em prosa, entrega saídas estruturadas, como uma escolha, uma pontuação ou a probabilidade de uma condição ser verdadeira. Isso pode simplificar a integração com um sistema. Mas não torna a decisão automaticamente correta, nem substitui um modelo generativo quando a tarefa exige escrever, resumir ou explicar.
Três propostas, diferenças importantes
A Decisions API da OpenAI usa o GPT-6 Luna e aceita entradas de texto e imagem. A documentação apresenta três tipos de uso: verificar a probabilidade de uma condição, escolher entre opções e pontuar uma entrada conforme uma rubrica. O preço anunciado é US$ 0,10 por milhão de tokens de entrada, sem cobrança por tokens de saída ou de cache. A OpenAI afirma que a API pode ser até dez vezes mais rápida que a Responses API. É uma afirmação da empresa, não uma comparação independente com Jev ou Clef.
A Cloudflare oferece Clef, de 27 bilhões de parâmetros, e Clef-flash, de 9 bilhões. Ambos aceitam texto e imagem e têm janela de contexto anunciada de 65.536 tokens, conforme o anúncio da Cloudflare. Estão disponíveis no Workers AI, e seus pesos podem ser baixados sob licença Apache 2.0. Os preços publicados são US$ 0,24 por milhão de tokens de entrada para Clef e US$ 0,09 para Clef-flash. A licença aberta dá mais opções de uso e hospedagem, mas não significa que todos os dados e componentes do treinamento sejam públicos.
O Jev, da TypeSafe AI, trabalha com texto, não com imagens. Seu preço publicado é US$ 0,042 por milhão de tokens de entrada, sem cobrança por tokens de saída. Clef e Clef-flash são compatíveis com a API System One; segundo a Cloudflare, isso pode facilitar a migração de integrações com Jev, alterando o endpoint e o modelo.
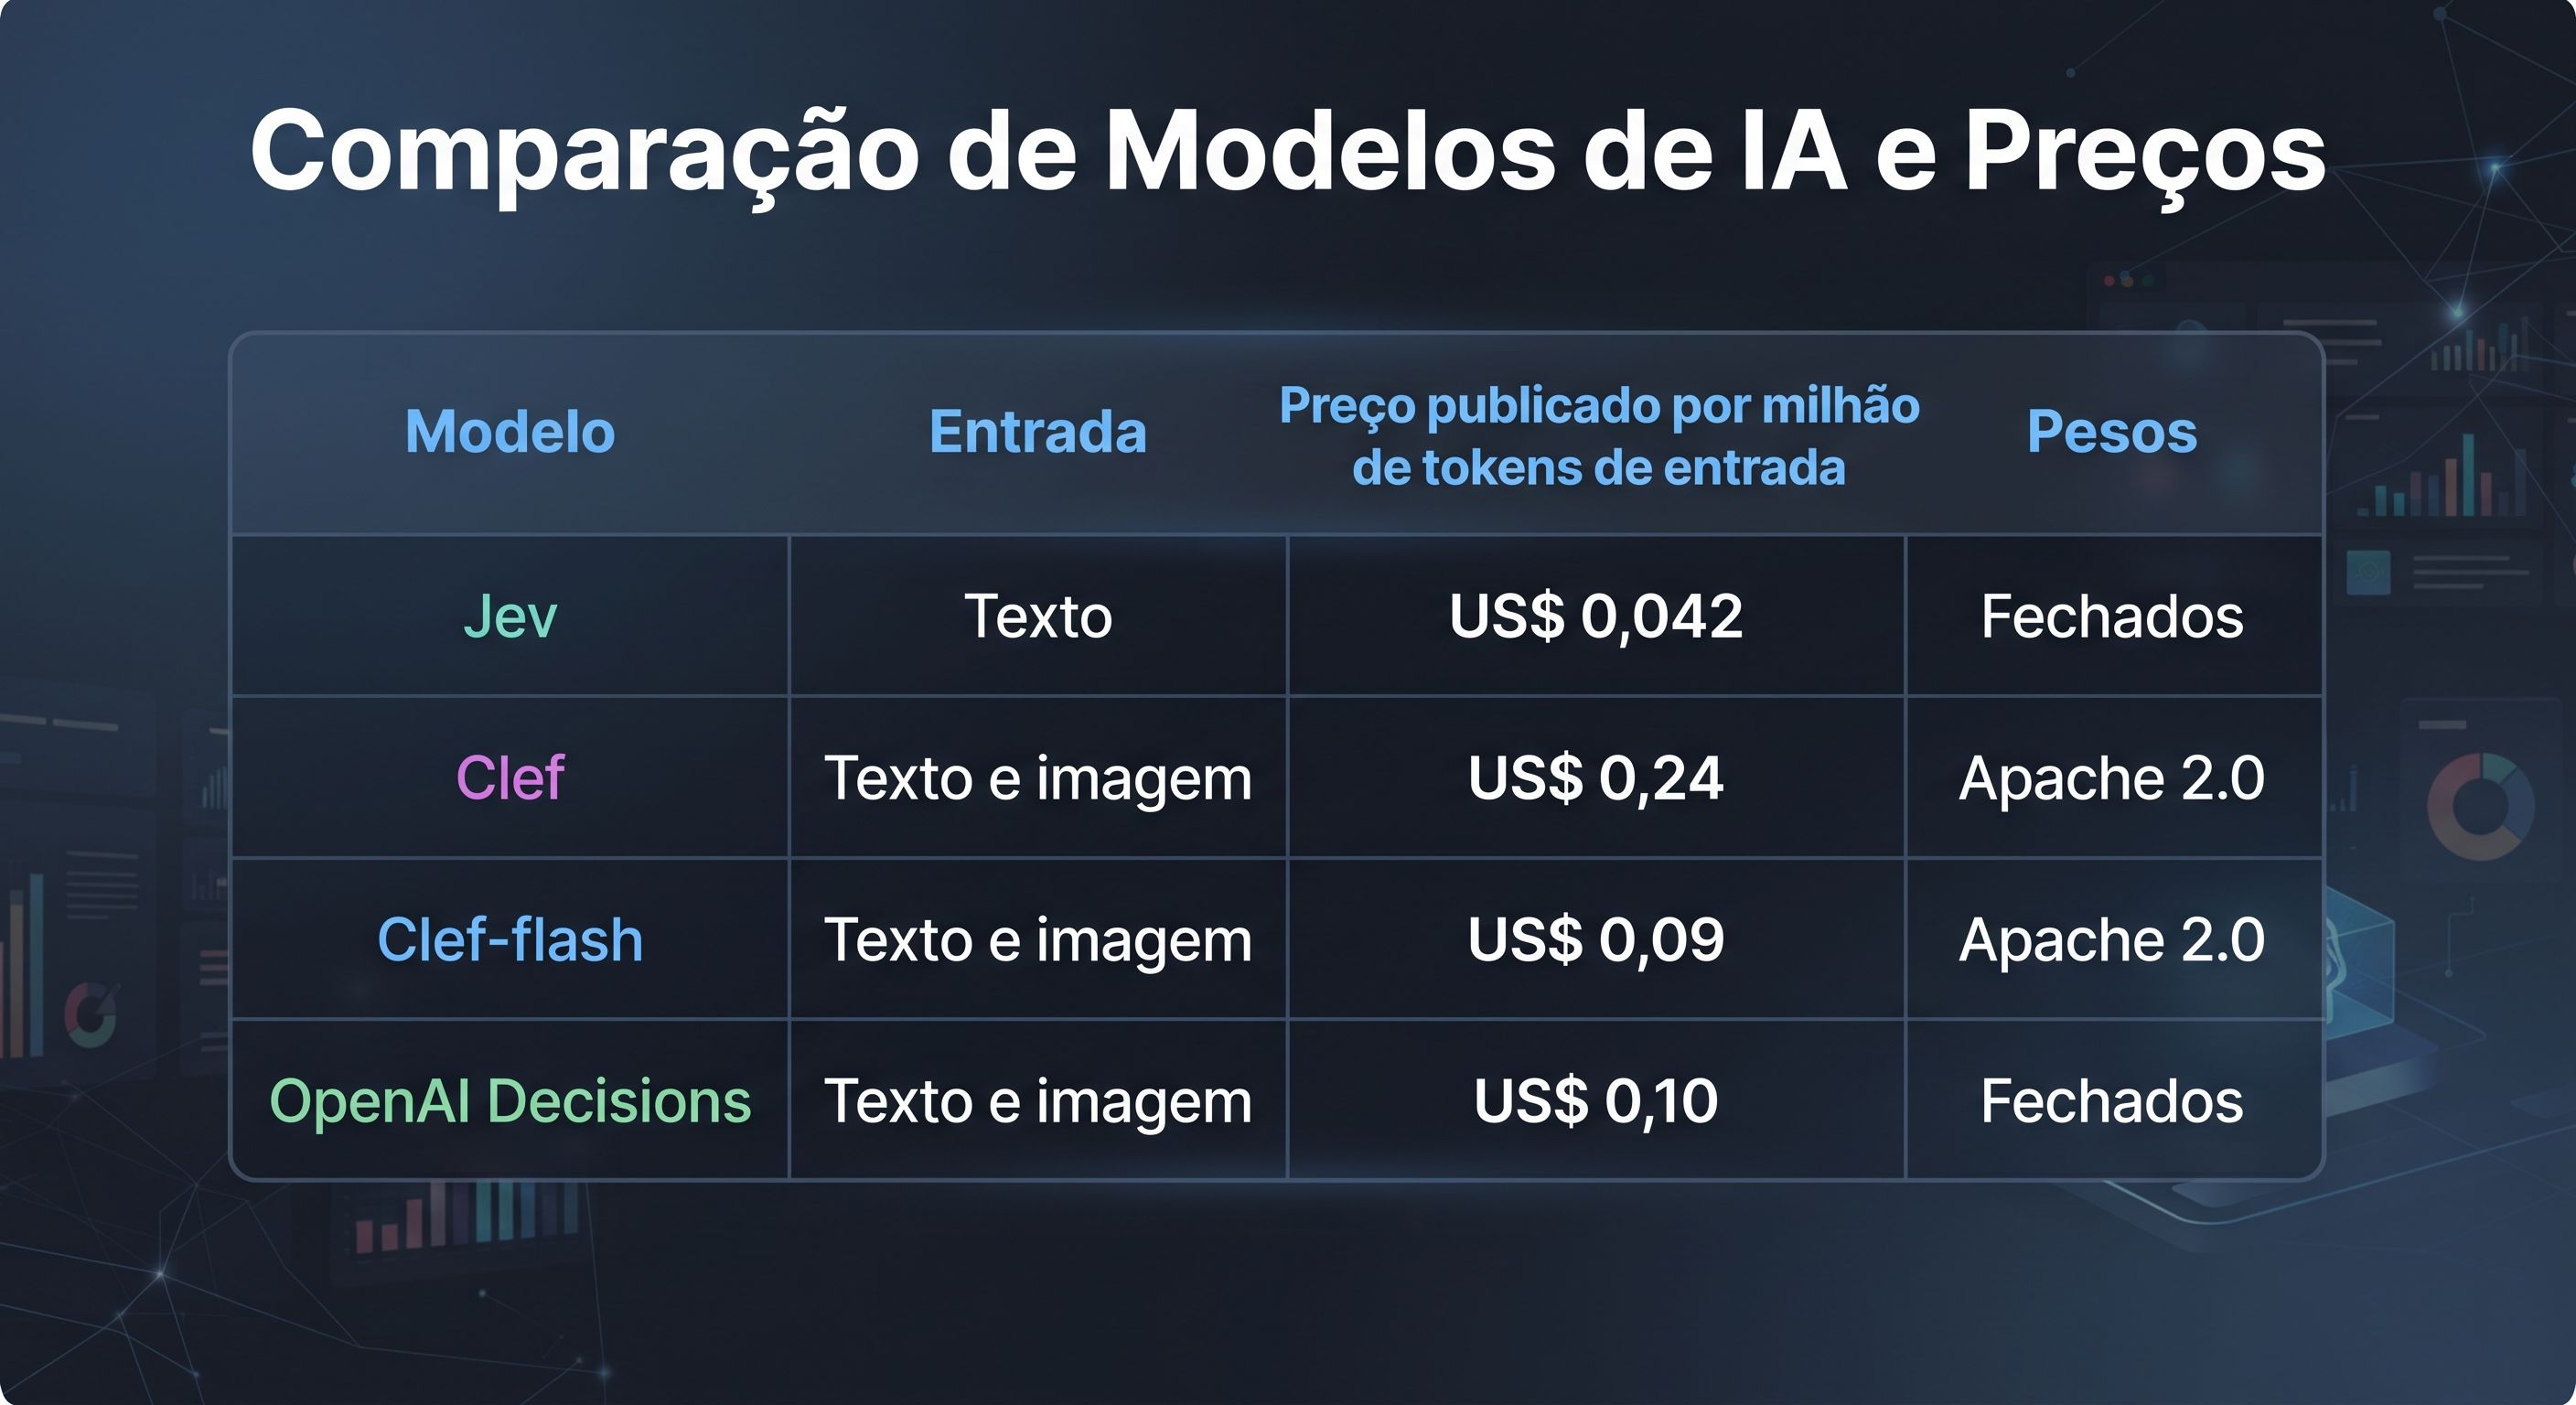
Esses valores são tarifas de entrada, não o custo total da operação. A conta também depende do volume, do tamanho das entradas, do número de perguntas por chamada, de novas tentativas, de gateways, da infraestrutura e da revisão humana.
Benchmarks: o vencedor depende da tarefa
A Cloudflare publicou medianas de latência de 209,3 ms para Clef, 38,8 ms para Clef-flash e 524,1 ms para Jev em seus testes. Nos benchmarks divulgados pela própria empresa, Clef ficou à frente de Jev em BANKING77, com macro-F1 de 94,20 contra 79,74. Já no teste When2Call, Jev superou Clef em acurácia: 80,97 contra 72,37. São resultados da Cloudflare, não uma reprodução independente.
Uma comparação publicada pela JevStation avaliou cinco modelos. Em intenções de cartão do conjunto Banking77, Clef-flash marcou 97,9%, Clef 94,8%, OpenAI Luna Decisions 90,5% e Jev 86,5%. Na classificação de notícias do AG News, os resultados ficaram entre 89% e 93%. O estudo também reportou respostas erradas com confiança igual ou superior a 0,99 para OpenAI Decisions e Jev, mas não para Clef ou Clef-flash.
Esses dados são um sinal para investigar, não uma classificação definitiva. Sem uma avaliação na sua própria operação, diferenças entre modelos podem não se repetir. E confiança alta não é garantia de acerto.
A latência também depende do percurso medido. A JevStation publicou medianas via OpenRouter de 412 ms para Jev, 594 ms para Clef-flash, 649 ms para Clef e 486 ms para OpenAI Luna Decisions. Essas medições não são diretamente comparáveis às da Cloudflare, que usou outro método e outro ambiente.
Em um piloto da Startrise com tarefas pequenas, Clef concordou com as referências em 150 de 167 decisões, e Jev em 149 de 167. A diferença é de uma decisão numa amostra limitada; concordância não equivale a precisão geral. Nesse percurso, Jev levou 320 ms por decisão e Clef, 655 ms; Clef-flash, 316 ms. A divergência entre medições reforça a importância de testar nas condições em que o modelo será usado.
Quanto custa na prática?
Uma estimativa da JevStation, baseada em 100 mil avaliações mensais, textos médios de 1.500 caracteres e três perguntas por avaliação, calculou custos diretos aproximados de US$ 2,66 para Jev, US$ 5,53 para Clef-flash, US$ 6,84 para OpenAI Decisions e US$ 14,74 para Clef. É uma estimativa baseada nos tokens daquele cenário, não uma previsão universal.
As análises da O-mega e da Startupik ajudam a entender como a categoria era descrita nos primeiros dias. Publicadas em 3 e 4 de outubro, elas retratavam a Decisions API como preview limitado, o que correspondia ao status da API naquelas datas. A cobertura mudou depois de 6 de outubro, quando a OpenAI anunciou a abertura do beta público e publicou condições de preço. Já a análise do AIHackers é principalmente documental: os autores indicam que não executaram inferências para comparar o desempenho dos modelos.
Como escolher sem transformar benchmark em promessa
Eu não escolheria um vencedor universal. Começaria pela tarefa e pelo custo de errar. Para várias categorias de texto e decisões no caminho crítico, Clef-flash merece ser testado. Para quem quer avaliar pesos disponíveis ou hospedagem própria, Clef e Clef-flash dão mais opções, embora operar os modelos também traga custos e responsabilidades.
Jev pode fazer sentido em fluxos textuais quando o preço por token é relevante. OpenAI Decisions pode ser avaliada em beta público, com preço de entrada conhecido e suporte a imagens. Mas a velocidade anunciada pela OpenAI não deve ser tratada como garantia para o tempo total da aplicação.
Eu compararia os candidatos com exemplos reais, incluindo casos ambíguos e situações em que o sistema deveria se abster. Mediria acerto por tipo de tarefa, erros de alta confiança, latência ponta a ponta e custo por volume. Em decisões capazes de causar prejuízo ou prejudicar a experiência do cliente, manteria revisão humana.
Na sua empresa, esses modelos já foram testados com exemplos reais e critérios de erro definidos ou a escolha ainda está sendo feita com base nos benchmarks de quem vende a tecnologia?
Alexandre Guimarães
Especialista em Inteligência Artificial e Transformação Digital
Gostou do artigo?
Entre em contato para discutir como podemos ajudar sua empresa com Inteligência Artificial e Transformação Digital.